linux并发产生的原因
(1)多线程并发访问,
(2)抢占式并发访问,进程调度可以在任意时刻抢占正在运行的线程,从而运行其他的线程
(3)终端程序并发访问
(4)SMP(多核)间并发访问
并发访问的后果就是竞争,一般像全局变量,设备结构体这些肯定是要保护的,至于其他的数据就要根据实际的驱动程序而定了。
一、原子操作
(1)原子操作的原因
对于c语言来说,a=3,编译为汇编语言时可能被翻译成如下汇编(仅作为理解)
1 | |
当并发出现时可能出现这种情况: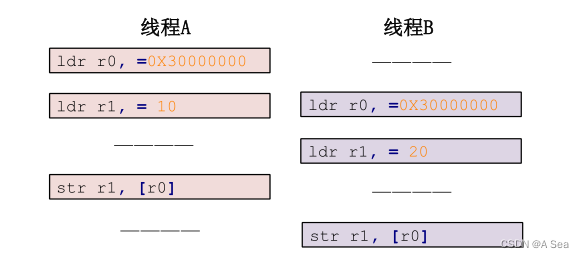
(2)原子操作api
为避免上述情况,Linux 内核定义了叫做 atomic_t 的结构体来完成整形数据的原子操作,在使用中用原子变量来代替整形变量,此结构体定义在 include/linux/types.h 文件中,
1 | |
声明变量可以这样,atomic_t a;
linux提供了多个可以对原子变量进行操作的函数,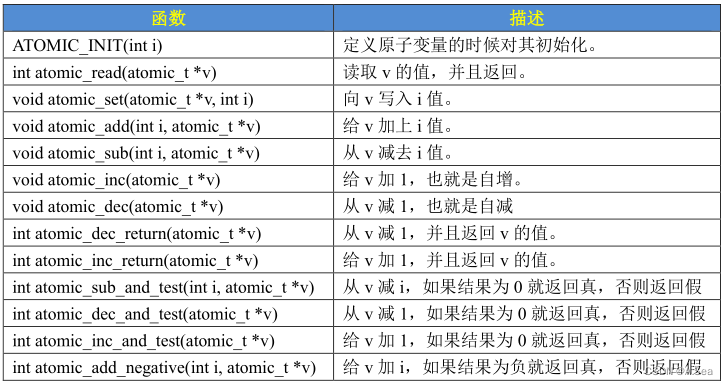
二、自旋锁
原子操作只能对整形变量或者位进行保护,但是,在实际的使用环境中怎么可能只有整形变量或位这么简单的临界区。举个最简单的例子,设备结构体变量就不是整型变量,我们对于结构体中成员变量的操作也要保证原子性,在线程 A 对结构体变量使用期间,应该禁止其他的线程来访问此结构体变量,这些工作原子操作都不能胜任,需要锁机制,在 Linux内核中就是自旋锁。
当一个线程要访问某个共享资源的时候首先要先获取相应的锁,锁只能被一个线程持有,只要此线程不释放持有的锁,那么其他的线程就不能获取此锁。对于自旋锁而言,如果自旋锁正在被线程 A 持有,线程 B 想要获取自旋锁,那么线程 B 就会处于忙循环-旋转-等待状态,线程 B 不会进入休眠状态或者说去做其他的处理,而是会一直傻傻的在那里“转圈圈”的等待锁可用。
从这里我们可以看到自旋锁的一个缺点:那就等待自旋锁的线程会一直处于自旋状态,这样会浪费处理器时间,降低系统性能,所以自旋锁的持有时间不能太长。所以自旋锁适用于短时期的轻量级加锁。
1 | |
自旋锁接口函数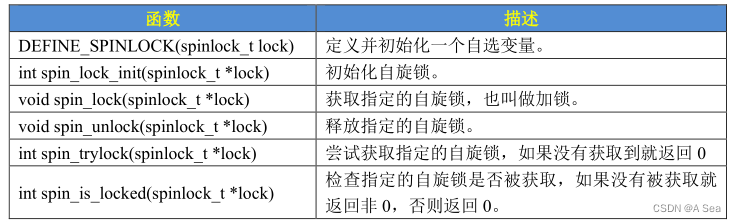
自旋锁保护的临界区一定不能调用任何能够引起睡眠和阻塞的API 函数,否则的话会可能会导致死锁现象的发生,经典死锁的发生例子:
线程a在持有锁期间进入了休眠,被调度出去,此时线程b想要获取锁,但是锁被线程a持有,并且内核抢占被禁止了,线程b无法调度出去一直等待锁被释放,而线程a此时也无法再次被调度运行,死锁就发生了。
还有就是中断里使用锁的时候也一定注意死锁的发生,例如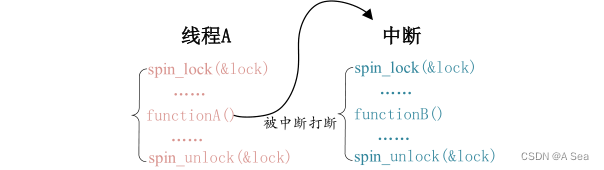
线程 A 先运行,并且获取到了 lock 这个锁,当线程 A 运行 functionA 函数的时候中断发生了,中断抢走了 CPU 使用权。右边的中断服务函数也要获取 lock 这个锁,但是这个锁被线程 A 占有着,中断就会一直自旋,等待锁有效。
最好的解决方法就是获取锁之前关闭本地中断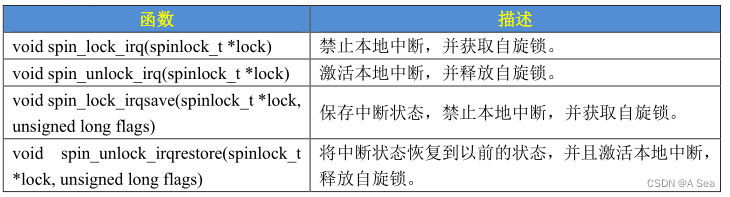
1 | |
自旋锁的使用注意事项;
(1)因为在等待自旋锁的时候处于“自旋”状态,因此锁的持有时间不能太长,一定要
短,否则的话会降低系统性能。如果临界区比较大,运行时间比较长的话要选择其他的并发处
理方式,比如信号量和互斥体。
(2)自旋锁保护的临界区内不能调用任何可能导致线程休眠的 API 函数,否则的话可能
导致死锁.
(3)不能递归申请自旋锁,因为一旦通过递归的方式申请一个你正在持有的锁,那么你就
必须“自旋”
三、信号量
相比较自旋锁,信号量可以使线程进入休眠状态,比如 A 与 B、C 合租了一套房子,这个房子只有一个厕所,一次只能一个人使用。某一天早上 A 去上厕所了,过了一会 B 也想用厕所,因为 A 在厕所里面,所以 B 只能等到 A 用来了才能进去。B 要么就一直在厕所门口等着,等 A 出来,这个时候就相当于自旋锁。B 也可以告诉 A,让 A 出来以后通知他一下,然后 B 继续回房间睡觉,这个时候相当于信号量。使用信号量会提高处理器的使用效率,但是,信号量的开销要比自旋锁大,因为信号量使线程进入休眠状态以后会切换线程,切换线程就会有开销。
信号量的特点:
(1)因为信号量可以使等待资源线程进入休眠状态,因此适用于那些占用资源比较久的场
合。
(2)信号量不能用于中断中,因为信号量会引起休眠,中断不能休眠。
(3)如果共享资源的持有时间比较短,那就不适合使用信号量了,因为频繁的休眠、切换线程引起的开销要远大于信号量带来的那点优势。
信号量一般有一个信号量值,可通过信号量值控制方位共享资源的访问数量。例如一个房间有10吧钥匙,相当于信号量值为10,如果想要进入房间,那就需要先获取一把钥匙,信号量值减1,直到10把钥匙都被拿走,信号量为0,此时就不允许人进入房间了,如果有人出来,那么就可以在允许一个人进入。
1 | |
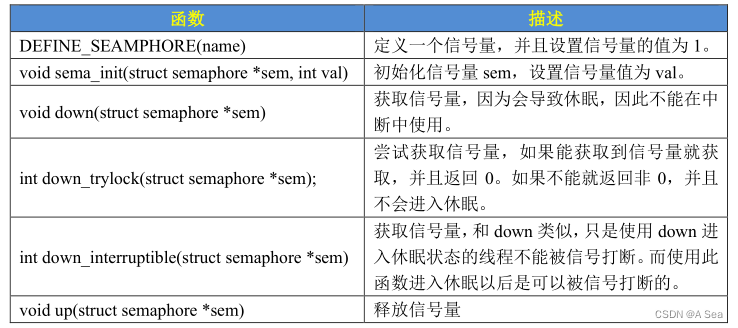
信号量的 API 函数:
1 | |
四、互斥体
将信号量的值设置为 1 就可以使用信号量进行互斥访问,但是互斥体有专门的结构体,
1 | |
特点:
(1)mutex 可以导致休眠,因此不能在中断中使用 mutex,中断中只能使用自旋锁。
(2)和信号量一样,mutex 保护的临界区可以调用引起阻塞的 API 函数。
(3)因为一次只有一个线程可以持有 mutex,因此,必须由 mutex 的持有者释放 mutex。并
且 mutex 不能递归上锁和解锁.
互斥体的接口函数: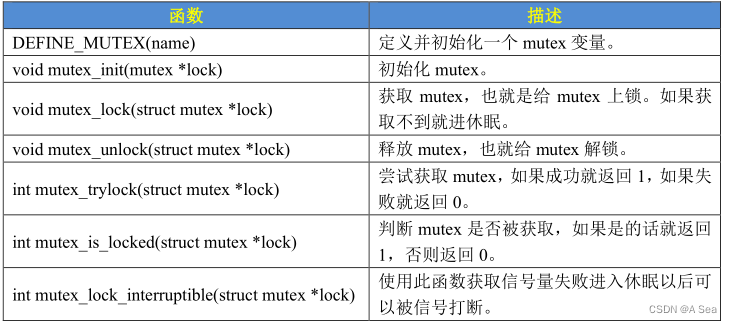
1 | |
五、RCU
RCU(Read-Copy Update),是 Linux 中比较重要的一种同步机制。顾名思义就是“读,拷贝更新”,再直白点是“随意读,但更新数据的时候,需要先复制一份副本,在副本上完成修改,再一次性地替换旧数据”。这是 Linux 内核实现的一种针对“读多写少”的共享数据的同步机制。
适用的场景:
我们前面说过,每种锁都有自己的适用的场景:spin lock不区分reader和writer,对于那些读写强度不对称的是不适合的,RW spin lcok和seq lock解决了这个问题,不过seq lock倾向writer,而RW spin lock更照顾reader。看起来一切都已经很完美了,但是,随着计算机硬件技术的发展,CPU的运算速度越来越快,相比之下,存储器件的速度发展较为滞后。在这种背景下,获取基于counter(需要访问存储器件)的锁(例如spin lock,rwlock)的机制开销比较大。而且,目前的趋势是:CPU和存储器件之间的速度差别在逐渐扩大。因此,那些基于一个multi-processor之间的共享的counter的锁机制已经不能满足性能的需求,在这种情况下,RCU机制应运而生(当然,更准确的说RCU一种内核同步机制,但不是一种lock,本质上它是lock-free的),它克服了其他锁机制的缺点,但是,甘蔗没有两头甜,RCU的使用场景比较受限,主要适用于下面的场景:
(1)RCU只能保护动态分配的数据结构,并且必须是通过指针访问该数据结构
(2)受RCU保护的临界区内不能sleep(SRCU不是本文的内容)
(3)读写不对称,对writer的性能没有特别要求,但是reader性能要求极高。
(4)reader端对新旧数据不敏感。
常用函数为:
1 | |